 На карте
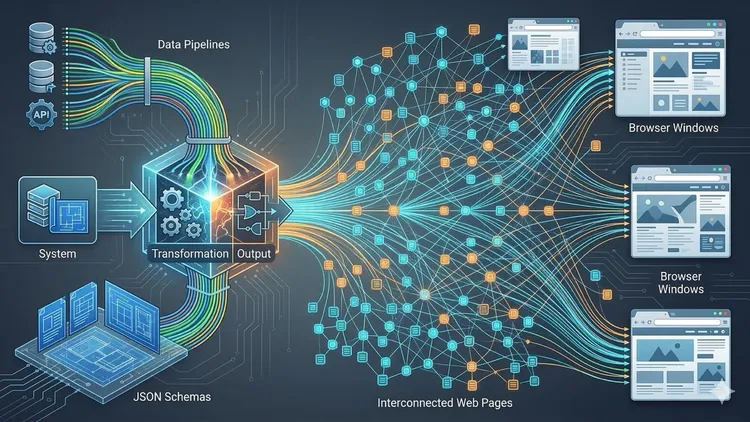
XCrawl — API-сервис для получения поисковой выдачи и содержимого сайтов в форматах, удобных для языковых моделей. Он умеет обрабатывать отдельные страницы, находить URL внутри сайта, запускать многостраничный обход и возвращать Markdown, HTML, ссылки, сводку, скриншоты или структурированный JSON.
Какие задачи решает XCrawl
XCrawl объединяет четыре основных сценария работы с веб-данными. По состоянию на 7 сентября 2026 года официальная документация описывает Scrape, Search, Map и Crawl API.
| Модуль | Что делает | Когда нужен |
| Scrape API | Получает одну страницу и возвращает выбранные форматы | Забрать статью, карточку товара или страницу документации |
| Search API | Ищет по ключевому запросу с настройками региона, языка и числа результатов | Собрать источники, изучить выдачу или найти релевантные страницы |
| Crawl API | Асинхронно обходит несколько страниц сайта по заданным правилам | Собрать раздел документации или часть домена |
| Map API | Находит URL сайта и помогает понять его структуру | Подготовить список страниц перед выборочным обходом |
Scrape и Crawl поддерживают браузерный рендеринг JavaScript. В запросе можно настроить момент ожидания страницы, размер окна браузера, устройство, локаль, заголовки, cookies и регион прокси. Результат доступен в форматах html, raw_html, markdown, links, summary, screenshot и json.
Структурированный JSON можно получить по текстовому заданию или схеме JSON (JSON Schema). Это удобно, когда нужны отдельные поля страницы: название, цена, ссылка или другие сущности.
Сбор и обработка данных находятся на разных этапах
XCrawl получает страницы и поисковые результаты, после чего передаёт их в подходящем формате. Сервис может вернуть сводку через формат summary. Ответы на вопросы, классификация, проверка извлечённых сущностей и сохранение результата остаются задачами вашей модели и прикладного кода.
Типовой поток выглядит так:
- Map или Search формирует список подходящих URL.
- Scrape или Crawl получает содержимое страниц.
- Приложение очищает, проверяет и сохраняет результат.
- Языковая модель использует подготовленные данные для поиска, анализа или ответа.
Первый запрос к Scrape API
После регистрации получите API-ключ в дашборде. Официальный API использует Bearer Token в заголовке Authorization.
Команды и поля ниже сверены с официальной документацией по состоянию на 7 сентября 2026 года. Реальный запрос при подготовке материала не выполнялся, поэтому раздел проверки описывает ожидаемый признак успеха.
Сохраните ключ в переменной окружения:
export XCRAWL_API_KEY="ваш-api-ключ"Запрос одной страницы в Markdown:
curl -s -X POST 'https://run.xcrawl.com/v1/scrape' \
  -H "Authorization: Bearer $XCRAWL_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "url": "https://example.com",
    "output": {
      "formats": ["markdown"]
    }
  }'
По умолчанию Scrape работает синхронно: соединение остаётся открытым до получения результата. Для долгой операции передайте mode: async. В ответе появится scrape_id, по которому можно отдельно запросить состояние задачи или получить результат через callback (webhook).
XCRAWL_API_KEY.Как проверить результат
Успешный синхронный ответ Scrape содержит status со значением completed и объект data. Если был запрошен Markdown, текст находится в data.markdown.
Также проверьте:
data.metadata.status_code— HTTP-статус целевой страницы;data.metadata.final_url— итоговый адрес после перенаправлений;data.credits_used— расход кредитов на результат;data.credits_detail— разбивку базовой стоимости, трафика и извлечения JSON;total_credits_used— общий расход по задаче.
Для проверки интеграции достаточно запросить https://example.com и убедиться, что ответ завершён, HTTP-статус равен 200, а data.markdown содержит заголовок страницы.
Настройка обхода сайта
Crawl API принимает начальный URL и правила обхода. По умолчанию документация указывает лимит 100 страниц и максимальную глубину 3.
curl -s -X POST 'https://run.xcrawl.com/v1/crawl' \
  -H "Authorization: Bearer $XCRAWL_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "url": "https://docs.xcrawl.com/doc/",
    "crawler": {
      "limit": 20,
      "max_depth": 2,
      "include": ["/doc/"],
      "exclude": ["/zh/"],
      "include_subdomains": false,
      "include_external_links": false
    },
    "output": {
      "formats": ["markdown"]
    }
  }'
Crawl создаёт асинхронную задачу и возвращает crawl_id. После запуска запросите результат через Crawl Result API либо настройте webhook. В завершённом ответе сравните поля completed и total, проверьте статус каждой страницы и общий расход кредитов.
Параметры include и exclude поддерживают шаблоны, включая регулярные выражения. Начинайте с небольшого limit: так проще проверить правила и не потратить кредиты на ненужные разделы.
Поиск с ограничением региона и языка
Search API принимает запрос, регион, язык и лимит результатов. Допустимый limit находится в диапазоне от 1 до 100; значение по умолчанию — 10.
curl -s -X POST 'https://run.xcrawl.com/v1/search' \
  -H "Authorization: Bearer $XCRAWL_API_KEY" \
  -H 'Content-Type: application/json' \
  -d '{
    "query": "site:docs.xcrawl.com XCrawl API",
    "location": "US",
    "language": "en",
    "limit": 10
  }'
В data.data возвращается список результатов с позицией, заголовком, описанием и URL. Значение региона обрабатывается в режиме best effort, поэтому для задач, чувствительных к географии, сверяйте выдачу на контрольном запросе.
Подключение через MCP
Официальный сервер MCP (Model Context Protocol, протокол взаимодействия с внешними инструментами) даёт Claude Code инструменты для получения страницы, поиска, построения карты URL, массового обхода и проверки асинхронных задач. Доступны облачное подключение и локальный запуск через npx; для локального варианта требуется Node.js 18 или новее.
Облачное подключение к Claude Code:
claude mcp add --transport http xcrawl https://mcp.xcrawl.com/{YOUR_API_KEY}/mcpЛокальный вариант без ключа в URL:
claude mcp add xcrawl -e XCRAWL_API_KEY={YOUR_API_KEY} -- npx -y xcrawl-mcpПроверка конфигурации:
claude mcp list
claude mcp get xcrawl
Для проектного файла .mcp.json в локальном варианте с npx используйте переменную окружения ${XCRAWL_API_KEY} в поле env, чтобы ключ не оказался в Git.
Внутри Claude Code откройте /mcp и убедитесь, что сервер подключён и инструменты XCrawl доступны.
Кредиты и планирование расходов
По состоянию на 7 сентября 2026 года официальный MCP-гайд заявляет 1000 бесплатных кредитов после регистрации. Расход зависит от выполненной операции и дополнительных функций.
Ответ API показывает фактическую стоимость в credits_used и детализацию в credits_detail. Для Scrape в детализации есть base_cost, traffic_cost и json_extract_cost; значения показывают базовый расход, стоимость трафика и стоимость извлечения JSON.
Точная стоимость и правила списания могут меняться. Перед массовым запуском сверяйте баланс и актуальные условия в дашборде и официальной документации XCrawl.
Полезные сценарии
База знаний для RAG
Исходные данные — список страниц документации. Сначала получите URL через Map, затем обработайте выбранные разделы с помощью Crawl и сохраните Markdown вместе с исходным URL и временем получения.
Наблюдаемый результат: в хранилище есть документы с непустым основным текстом, корректными адресами и успешными HTTP-статусами. Перед индексацией удалите дубли и служебные элементы страниц.
Сценарий не подходит для закрытых материалов, если у вас нет законного доступа и разрешённого способа передать авторизационные данные.
Мониторинг изменений на сайтах
Составьте ограниченный список публичных страниц и регулярно вызывайте Scrape. Сравнивайте нормализованный текст или нужные поля JSON с предыдущей версией.
Наблюдаемый результат: система создаёт событие только при содержательном изменении; перестановки баннеров и служебной разметки его не вызывают. Частоту запросов согласуйте с правилами сайта и реальной скоростью обновления данных.
Поиск источников для ИИ-агента
Передайте тему в Search API, отберите релевантные URL и получите их содержимое через Scrape. Агент должен сохранять ссылки на источники и отделять найденный текст от собственных выводов.
Наблюдаемый результат: ответ можно проверить по исходным страницам. Поисковая позиция сама по себе не подтверждает достоверность источника.
Структурированное извлечение
Для однотипных страниц задайте JSON Schema и извлекайте одинаковый набор полей. После получения проверьте обязательные значения, типы и допустимые диапазоны прикладным кодом.
Наблюдаемый результат: данные проходят проверку схемы и могут быть загружены в таблицу или базу. На страницах с разной структурой потребуется отдельная обработка ошибок и пропущенных полей.
Ограничения и безопасное использование
- Соблюдайте условия использования целевого сайта, авторские права и требования к персональным данным.
- Не считайте доступность публичной страницы разрешением на неограниченный массовый сбор.
- Тестируйте JavaScript-тяжёлые и защищённые сайты отдельно. Наличие браузерного рендеринга и прокси не гарантирует успешный результат для любого ресурса.
- Ограничивайте глубину, число страниц, внешние ссылки и поддомены до первого массового запуска.
- Проверяйте качество Markdown и JSON: извлечённые данные могут содержать навигацию, пропуски и неверно распознанные поля.
- Храните API-ключ в менеджере секретов или переменной окружения и регулярно проверяйте расход кредитов.
- Для критичного процесса предусмотрите повторные попытки, журнал ошибок и альтернативный способ получения данных.
Официальные ссылки
- Официальный сайт: xcrawl.com
- Документация и быстрый старт: docs.xcrawl.com
- Scrape API: официальная справка
- Search API: официальная справка
- Crawl API: официальная справка
- MCP для Claude Code: руководство по подключению
- Дашборд и API-ключи: dash.xcrawl.com
Следующий шаг
Как собрать данные с сотен сайтов конкурентов и подать их в Codex
Если вы строите сбор веб-данных для RAG, мониторинга или ИИ-агента, начать лучше с небольшого набора реальных страниц и измеримого критерия качества.
Если захотите обсудить, как это применить у себя или в команде — пишите в Telegram @pimenov