 На карте
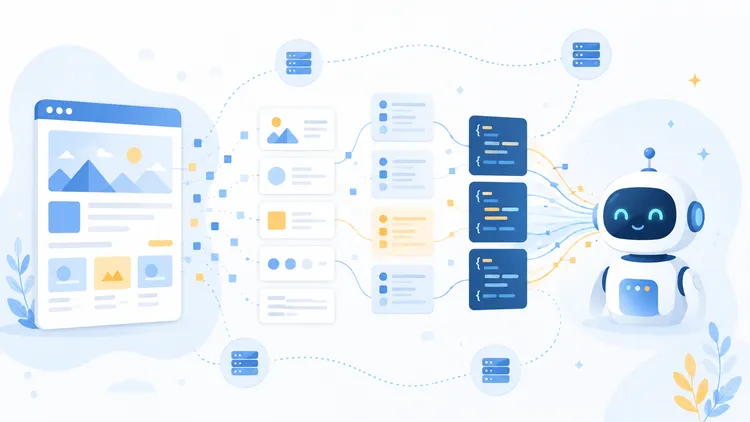
Firecrawl — API для поиска, сбора и обработки веб-данных. Он возвращает чистый Markdown, структурированный JSON, релевантные выдержки или ответ на вопрос, а также умеет обходить сайты, разбирать документы, управлять браузерными сессиями и отслеживать изменения.
Что это такое
Firecrawl принимает URL, файл или поисковый запрос и возвращает данные, подготовленные для языковой модели. Сервис рендерит JavaScript, использует прокси и средства обхода антибот-защиты, работает с динамическими страницами и поддерживает браузерные сессии.
Проект с открытым исходным кодом доступен в репозитории firecrawl/firecrawl. Облачный API работает по адресу https://api.firecrawl.dev; актуальная документация и эндпоинты используют версию v2.
Ключевые обновления 2026 года
| Дата | Что появилось |
| 20 августа | Developer Index для кодовых агентов: поиск по более чем 70 млн артефактов, включая README, внешнюю документацию, issues, pull requests и OpenAPI-спецификации. Доступен через API /search/developer, CLI, MCP и SDK |
| 13 августа | В Research Index добавлена категория Life Sciences с 41 млн+ научных работ. Все категории Research Index стали бесплатными |
| 22 июля | Обновлённый /search начал возвращать наиболее релевантные выдержки. Firecrawl сообщает о результате 94,7% на SimpleQA и примерно в 10 раз меньшем числе токенов по сравнению с обработкой полных страниц; это собственные измерения компании |
| 1 июля | Веб-масштабный /monitor: наблюдение за всем вебом по поисковым запросам и сформулированной цели |
| 24 июня, v2.11.0 | Research Index по 3 млн+ работ arXiv и связанным артефактам GitHub, доступ без ключа для /scrape, /search, /interact и /parse через официальные MCP-, CLI- и SDK-клиенты, redactPII, формат deterministicJson и поиск видео на страницах |
| 26 мая | /monitor для отслеживания изменений страниц и доставки уведомлений по вебхуку или электронной почте |
| 15 мая, v2.10 | /parse, Lockdown Mode, форматы question и highlights, официальные SDK для Go, Ruby, PHP и .NET |
| 10 апреля, v2.9.0 | /interact, режимы разбора PDF fast, auto и ocr, параметр onlyCleanContent, SDK для Java и Elixir |
Эндпоинты и индексы
| Эндпоинт | Что делает | Когда нужен |
/scrape | Преобразует одну страницу в Markdown, HTML, JSON, скриншот, выдержки или ответ на вопрос | Получение содержимого конкретной страницы |
/crawl | Обходит сайт с фильтрами путей и собирает содержимое страниц | Документация, база знаний, каталог |
/map | Возвращает список URL сайта | Разведка структуры перед обходом |
/search | Ищет в вебе и может возвращать содержимое найденных страниц | Свежие внешние данные для агента |
/parse | Разбирает файлы до 50 МБ: PDF, DOCX, DOC, ODT, RTF, XLSX, XLS и HTML | Подготовка документов для систем с дополнением ответов данными (RAG) и извлечения данных |
/agent | Автономно собирает веб-данные по задаче на естественном языке | Исследования и сложное извлечение без ручной схемы обхода |
/interact | Продолжает работу со страницей: нажимает кнопки, заполняет формы, выполняет код и переходит между страницами | Логин, пагинация и динамические интерфейсы |
/monitor | Запускает регулярные проверки страниц или веба и сообщает об изменениях | Мониторинг цен, релизов и документации |
/search/research | Ищет научные работы, позволяет читать их полный текст и находить связанные публикации | Исследования в AI/ML и Life Sciences |
/search/developer | Ищет фрагменты в документации и артефактах публичных репозиториев | Вопросы о коде, API, ошибках и известных проблемах |
Форматы, которые сокращают контекст
markdown— очищенный текст страницы и базовый формат для большинства задач.json— структурированный результат.deterministicJson— переиспользуемый экстрактор, который кешируется для сайта и делает повторное извлечение более согласованным и дешёвым.question— ответ на вопрос, обоснованный содержимым одной страницы.highlights— совпавшие с запросом предложения, строки кода и таблиц с сохранением исходного форматирования.video— найденные видео с URL, заголовком, превью, длительностью и другими метаданными.
По данным Firecrawl, форматы question и highlights могут требовать до 100 раз меньше токенов по сравнению с передачей полной страницы. Фактическая экономия зависит от документа и запроса.
Подключение к API
Для прямых API-вызовов с повышенными лимитами создайте API-ключ в дашборде и передавайте его в заголовке Authorization. Храните ключ в переменной окружения.
export FIRECRAWL_API_KEY="fc-ваш-ключ"
curl -X POST "https://api.firecrawl.dev/v2/scrape" -H "Authorization: Bearer $FIRECRAWL_API_KEY" -H "Content-Type: application/json" -d '{"url":"https://example.com","formats":["markdown"]}'
import os
from firecrawl import Firecrawl
firecrawl = Firecrawl(api_key=os.environ["FIRECRAWL_API_KEY"])
doc = firecrawl.scrape("https://example.com", formats=["markdown"])
print(doc)import { Firecrawl } from 'firecrawl'
const firecrawl = new Firecrawl({
apiKey: process.env.FIRECRAWL_API_KEY
})
const doc = await firecrawl.scrape('https://example.com', {
formats: ['markdown']
})
console.log(doc)Официальные SDK доступны для Python, Node.js, Go, Rust, Java, Elixir, Ruby, PHP и .NET.
Доступ без API-ключа
Страница Introduction показывает первый запрос к /scrape и пример /search без ключа; API-ключ добавляют для более высоких лимитов. В релизе v2.11.0 также заявлен доступ к /scrape, /search, /interact и /parse без ключа через официальные MCP-, CLI- и SDK-клиенты.
Для автоматизированного режима без интерактивного входа документация рекомендует API-ключ. Бесплатный план с аккаунтом предоставляет 1 000 кредитов в месяц.
Подключение Firecrawl к Codex
В официальной инструкции для Codex CLI основной вариант — размещённый MCP (Model Context Protocol, протокол подключения инструментов) с OAuth:
codex mcp add firecrawl --url https://mcp.firecrawl.dev/v2/mcp-oauth
codex mcp login firecrawl
После входа запустите новую сессию Codex, выполните /mcp и убедитесь, что подключение firecrawl активно.
Если нужен CLI и скиллы для поддерживаемых кодовых агентов, Firecrawl предлагает установку одной командой:
npx -y firecrawl-cli@latest init --all --browserПосле установки перезапустите агент. Скилл для Research Index устанавливается отдельно:
npx skills add firecrawl/skills@firecrawl-research-indexПроверка результата
Минимальная проверка — запрос /scrape из примера выше.
- Код из диапазона
2xxозначает успешный запрос. В полном ответе cURL должен появиться объектdataс запрошенным содержимым; SDK обычно возвращает его содержимое напрямую. - Код
401указывает на проблему с авторизацией. Для OAuth-подключения повторитеcodex mcp login firecrawl; для API-ключа проверьте переменную окружения. - Код
429означает превышение лимита запросов или конкурентности тарифа. - В учёте использования должен отразиться расход кредитов. Базовый
/scrapeстоит один кредит за страницу.
Если используете MCP в Codex, дополнительно попросите агента найти свежие примечания к выпуску или собрать заголовки документации и проверьте, что ответ содержит ссылки на источники.
Тарифы, лимиты и кредиты
Цены ниже проверены 10 сентября 2026 года. Страница тарифов указывает, что эти цены действуют с 4 сентября 2026 года и приведены за месяц при годовой оплате.
| План | Цена | Кредиты в месяц | Параллельные браузеры |
| Free | $0 | 1 000 | 2 |
| Hobby | $16 / мес | 5 000 | 5 |
| Standard | $83 / мес | 100 000 | 25 |
| Growth | $333 / мес | 500 000 | 50 |
| Scale | $599 / мес | 1 000 000 | 100 |
| Enterprise | По договору | Индивидуально | Индивидуально |
Hobby при помесячной оплате стоит $19. Для остальных планов перед покупкой проверяйте текущую помесячную цену на официальной странице.
Расход кредитов
/scrape,/crawlи/map— 1 кредит за страницу;/monitor— 1 кредит за страницу при каждой проверке;/search— 2 кредита за 10 результатов;/interact— 2 кредита за минуту работы браузера;/agent— 5 бесплатных запусков в день в период предварительного доступа, затем применяется динамическая цена;- форматы JSON, Question и Highlight в
/scrapeи/crawlдобавляют 4 кредита за страницу; - детерминированное извлечение в
/monitorтарифицируется по фиксированной ставке 7 кредитов за страницу за проверку.
Дополнительные кредиты и перенос остатков
На платных планах работает оплата по мере расходования (pay-as-you-go): когда баланс заканчивается, Firecrawl добавляет кредиты шагами по $5. Пользователь задаёт месячный предел расходов или отключает пополнение.
Один шаг даёт:
- Hobby — 1 000 кредитов;
- Standard — 2 000;
- Growth — 2 500;
- Scale — 5 000.
Купленные дополнительные кредиты сохраняются до использования, но сгорают при отмене подписки. Плановые кредиты Hobby, Standard и Growth на следующий период не переносятся. Scale переносит остаток на один месяц, а для Enterprise действуют индивидуальные условия.
Безопасность и приватность
- Lockdown Mode. Параметр
lockdown: trueв/scrapeразрешает отдавать данные только из индекса Firecrawl. Исходящие запросы, включая обращения к HTTP иrobots.txt, блокируются; URL не сохраняется, а данные задания удаляются после доставки. Режим доступен через API, SDK, CLI и MCP. - Удаление персональных данных. Опция
redactPIIубирает из результата имена, адреса, телефоны, электронную почту и секреты. - Zero Data Retention. Для Enterprise и одобренных корпоративных сценариев Firecrawl предлагает обработку без хранения полученного содержимого.
- Защита формата
question. Содержимое страницы изолируется XML-разметкой и экранированием с помощью символов нулевой ширины, а модель получает указание игнорировать инструкции внутри страницы.
Ограничения и когда сервис не подходит
- Перед сбором данных с крупных социальных сетей и сайтов за логином проверьте доступность источника, его условия использования и наличие официального API.
- Браузерные сессии тарифицируются по времени. Для статичных страниц дешевле использовать обычный
/scrape. - Форматы JSON, Question и Highlight требуют дополнительных кредитов. Включайте их, когда сокращение последующей обработки оправдывает цену.
/agentостаётся в предварительном доступе с динамической стоимостью. Для предсказуемого производственного процесса удобнее фиксированная схема извлечения.- Плановые кредиты большинства самостоятельных тарифов не переносятся, поэтому нерегулярные массовые обходы требуют расчёта заранее.
- Firecrawl не отменяет требования
robots.txt, условия сайтов и правила обработки персональных данных. Юридическая оценка остаётся на стороне пользователя.
Полезные сценарии
| Задача и входные данные | Что сделать | Проверяемый результат и ограничение |
| Ответить по свежей документации по известному запросу | Выполнить /search, затем для выбранной страницы вызвать /scrape с форматом highlights или question | В ответе есть релевантные фрагменты и ссылки. Заявления производителя о точности не заменяют проверку первоисточника |
| Собрать RAG-базу по документации сайта | Получить структуру через /map, ограничить нужные пути и запустить /crawl с Markdown | На выходе есть документы по ожидаемым URL. Перед большим обходом проверьте лимиты, дубли и стоимость |
| Следить за ценами, релизами или изменениями документации | Создать /monitor для страниц либо веб-поиска, задать расписание и доставку по вебхуку или почте | Контрольное изменение появляется в списке проверок и доставляется выбранным каналом. Каждая проверенная страница расходует кредиты |
| Разобрать договоры, счета или отчёты размером до 50 МБ | Передать файл в /parse; для документов с персональными данными включить redactPII | Получен Markdown или JSON с сохранёнными таблицами и порядком чтения. Для чувствительных данных отдельно проверьте договорные условия хранения |
| Регулярно извлекать одну структуру с одного сайта | Описать схему и использовать deterministicJson | Повторные запросы возвращают согласованную структуру. Изменение вёрстки источника всё равно требует контроля качества |
| Получить данные из динамического интерфейса | Сначала выполнить /scrape, затем продолжить сессию через /interact и при необходимости использовать сохранённый профиль | В ответе есть требуемые данные, а сессию можно наблюдать через режим просмотра (live view). Используйте браузер только для шагов, которые нельзя выполнить обычным запросом |
| Найти ответ о библиотеке или ошибке в коде | Через API выполнить поиск в Developer Index и сузить результаты по типу артефакта или репозиторию | Результат содержит устойчивый идентификатор, URL и совпавшие фрагменты из документации или репозитория. Фильтры этого уровня доступны в API; для CLI и MCP сверяйте фактический набор возможностей |
| Найти научную работу и проверить утверждение | Использовать Research Index: сначала поиск, затем чтение подходящей работы или подбор связанных публикаций | Получены ссылки на работы и текст для проверки утверждения. Оценка качества исследования остаётся отдельной задачей |
Для кого это полезно
Firecrawl подходит командам, которым нужно:
- давать агентам доступ к актуальным веб-источникам;
- строить RAG-системы по внешней документации;
- собирать конкурентную аналитику и следить за изменениями;
- превращать документы в Markdown или структурированные данные;
- искать научную и техническую литературу;
- использовать управляемые браузеры без собственной инфраструктуры прокси и headless-браузеров.
Ссылки
- Официальный сайт: firecrawl.dev
- Введение и быстрый старт: docs.firecrawl.dev/introduction
- Справочник API v2: docs.firecrawl.dev/api-reference/v2-introduction
- Подключение к Codex CLI: docs.firecrawl.dev/quickstarts/codex-cli
- Changelog: firecrawl.dev/changelog
- Тарифы: firecrawl.dev/pricing
- GitHub: github.com/firecrawl/firecrawl
Следующий шаг
Выбор способа подключения и тарифа зависит от источников, частоты сбора и дальнейшей обработки данных. Такой разбор полезен командам, которые строят агентов и хотят контролировать качество и стоимость веб-контекста.
Если захотите обсудить, как это применить у себя или в команде — пишите в Telegram @pimenov