Telegram Stars (XTR) — внутренняя валюта Telegram для оплаты цифровых товаров и услуг прямо в ботах. Разбираем, как устроены Stars, как принимать оплату через Bot API, как работают gifts, баланс бота, рефанды и какие сценарии монетизации это открывает для контентных, community- и AI-продуктов.
Официальное руководство OpenAI по промптингу GPT-5.5: outcome-first промпты, настройка личности модели, бюджеты поиска, валидация результатов и рекомендуемая структура системных промптов.
Linear — быстрый issue tracker и project-инструмент для команд разработки. Разбираем возможности, тарифы и интеграцию с OpenAI Codex: cloud-агент прямо в issues и MCP-сервер для Codex CLI и IDE.
Чеклисты в Telegram Bot API: как боты создают и редактируют списки задач от имени business account. Параметры, лимиты и сценарии для брифов, редакционного процесса и работы с клиентами.
Справочник по OpenAI Agents SDK: примитивы (Agents, Handoffs, Guardrails, Tracing), agent loop, sandbox, subagents, MCP и когда выбирать SDK вместо Responses API loop.
Краткий справочник по версии Notion API 2026-03-11: три breaking changes (position, in_trash, meeting_notes), что ломается в интеграциях и как безопасно переехать.
ru-text — open-source плагин для Claude Code, Codex, Cursor, Gemini, Notion и др. (~1 044 правила русской типографики, инфостиля, редактуры, UX и деловой переписки). Как установить, включить в агента и использовать «официальный редактор» русского для всех рабочих текстов.
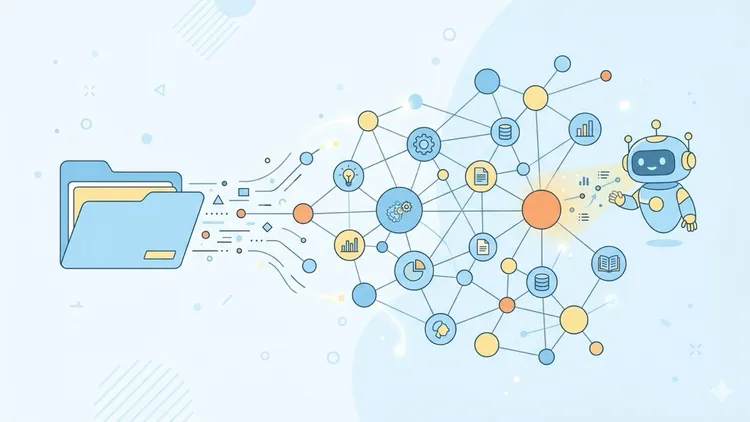
Open-source инструмент Graphify, который из любой папки (код, доки, PDF, Markdown, картинки) собирает queryable knowledge graph. Разбираем, как это работает, как ставить, и как связать с собственным контентным графом сайта.
Справочник по Google Analytics MCP Server: подключение GA4 к MCP-клиенту/агентному слою, модели доступа, примеры запросов и практики для agent-ready сайта.
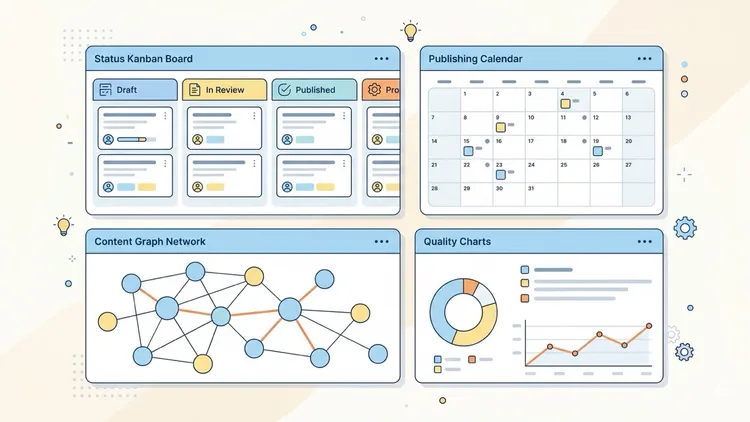
Как использовать Status-свойства Notion как управляющий слой пайплайна: опции, группы, создание и обновление через API и MCP, и как превратить Notion из хранилища в рабочий процесс.
Простыми словами про TF-IDF и semantic snapshot: как построить «kарту смыслов» для корпуса текстов без LLM и векторных embeddings, и как это живёт рядом с ручными тегами и графом сайта.
 1:17